

Ocena odbiorców: 27 modeli AI, ChatGPT na 8. miejscu – oto modele, które go przewyższyły

Chociaż świat sztucznej inteligencji (AI) może często wydawać się burzliwy, za kulisami przeprowadza się zaskakująco dużo analiz, pomiarów wydajności i testów. Robią to nie tylko same firmy, ale także grupy powołane do ustalania własnych rankingów.
Grupy te testują wszystko, od zdolności chatbota do wykonywania testów matematycznych,
Utwórz obrazylub podać logiczne wyjaśnienia, a nawet udzielić porady medycznej lub po prostu pokazać, jak bardzo jest inteligentna emocjonalnie.
Podczas tych zróżnicowanych testów modele ujawniają swoje mocne i słabe strony w różnych obszarach. Na przykład, choć GPT-5 wyróżnia się w dedukcji naukowej, to ustępuje modelom takim jak Gemini i Claude pod względem zdolności adaptacji do nowych koncepcji.
Każdy z tych testów mówi nam coś nowego o modelach AI i jest ważny, ponieważ przypomina nam, które narzędzia sprawdzają się najlepiej w różnych scenariuszach. Często jednak brakuje jednej metryki: które modele AI zapewniają najlepsze doświadczenia użytkownika?
System klasyfikacji humanoidalnej
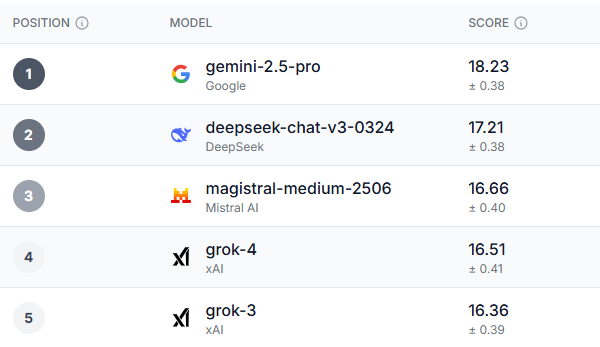
Brytyjska firma technologiczna Prolific stworzyła ranking sztucznej inteligencji o nazwie Humaine . Zamiast testować zdolność sztucznej inteligencji do wykonywania zadań, Prolific testował różne doświadczenia użytkowników z wykorzystaniem tych modeli.
Oceniając doświadczenia 21 352 osób z narzędziami, udało się nie tylko wyłonić zwycięzcę, ale także podzielić wyniki ze względu na wiek, lokalizację (testy przeprowadzono zarówno w Wielkiej Brytanii, jak i w USA) i poglądy polityczne.
Obejmuje to pojedyncze oferty dla:
- Wielka Brytania: Grupy wiekowe
- Wielka Brytania: Rasa
- Wielka Brytania: Poglądy polityczne
- Stany Zjednoczone: Grupy wiekowe
- Stany Zjednoczone: Rasa
- Stany Zjednoczone: Pogląd polityczny
Każdy uczestnik miał okazję do interakcji z dwoma różnymi modelami sztucznej inteligencji, aby je porównać, a następnie poproszono ich o podanie informacji zwrotnej na temat tego, który model wypadł lepiej w każdej interakcji.
W rezultacie wyłoniono zwycięzcę w klasyfikacji generalnej i tabeli liderów za wydajność, a także oddzielne rankingi za podstawowe wykonywanie zadań i rozumowanie, a także zwycięzcę za komunikację, odporność, zaufanie i etykę.
Co pokazują wyniki?
Po gruntownej analizie wyłoniono wyraźnego zwycięzcę, nie tylko w kategorii ogólnej wydajności, ale także w większości podkategorii. Gemini 2.5-Pro wyróżniał się w niemal każdym benchmarku objętym testem.
Młodzi dorośli w wieku 18-34 lat w Wielkiej Brytanii, wyborcy Partii Demokratycznej oraz osoby powyżej 55. roku życia w USA zgodnie uznali Gemini 2.5 Pro za najlepszy model w ogólnym rozrachunku. Jedynym obszarem, w którym wszystkie grupy demograficzne oceniły go wyżej niż Gemini, było zaufanie, etyka i bezpieczeństwo – był to Grok-3 – co jest nieco ironiczne, biorąc pod uwagę problemy z bezpieczeństwem i etyką, z jakimi borykał się ostatnio model sztucznej inteligencji.
Co ciekawe, trzy modele, które pojawiły się po Gemini, to Deepseek, Magistral Le Chat i Grok . Chociaż Deepseek cieszył się znaczną popularnością na początku tego roku, ostatnio zniknął z pola widzenia. Le Chat z kolei jest mniej popularnym chatbotem, ale może pochwalić się lojalną rzeszą użytkowników.
Gdzie w tym wszystkim plasuje się światowej sławy ChatGPT? Znajduje się na samym dole listy, zajmując ósme miejsce ze swoim najlepszym modelem GPT-4.1. Jeszcze gorzej jest z Claude , którego dwie wersje (4.0 i 4.0) zajęły odpowiednio jedenaste i dwunaste miejsce w klasyfikacji generalnej.
Co to wszystko oznacza?
Czy to oznacza, że Gemini jest najlepszym chatbotem AI na świecie? Czy to oznacza, że powinieneś porzucić ChatGPT…? Cóż, nie do końca.
Te wyniki niekoniecznie odzwierciedlają wydajność tych modeli. Podczas testów na większości innych metryk, opcje, które zazwyczaj widzimy na górze, to ChatGPT, Gemini, Claude i Grok.
Jest to jednak ważny dodatek do tych testów. Pomagają nam lepiej zrozumieć sztuczną inteligencję z perspektywy ludzkiego doświadczenia. Na przykład Le Chat nie osiąga wysokich wyników w standardowych testach porównawczych, ale często jest uznawany za doskonały wybór pod względem doświadczenia i wiarygodności.
Chociaż wyniki Anthropic i OpenAI nie osiągnęły tak wysokiego poziomu w tej rundzie testów, Gemini i Grok zaliczyły kolejny dobry występ. Obie firmy często osiągają wysokie wyniki w standardowych testach porównawczych i tak było również w tym przypadku.

Możliwość dodawania komentarzy nie jest dostępna.