

Wyjaśnienie: W jaki sposób regularyzacja L1 automatycznie wybiera cechy?
Poznaj proces automatycznego wyboru cech wykonywany przez regularyzację L1 (LASSO).
Selekcja cech to proces wybierania optymalnego podzbioru cech z danego zbioru cech; optymalny podzbiór to taki, który maksymalizuje wydajność modelu w odniesieniu do danego zadania.
Selekcja cech może być procesem ręcznym lub, dokładniej, jawnym, gdy jest przeprowadzana za pomocą metod filtrowania lub zawijania . W tych metodach cechy są wielokrotnie dodawane lub usuwane w oparciu o ustaloną wartość metryki, która określa ich znaczenie w tworzeniu prognoz. Metrykami tymi mogą być przyrost informacji, wariancja lub statystyka chi-kwadrat, a algorytm decyduje o akceptacji lub odrzuceniu cechy na podstawie ustalonego progu metryki. Należy pamiętać, że metody te nie są częścią fazy uczenia modelu i są wykonywane wcześniej.
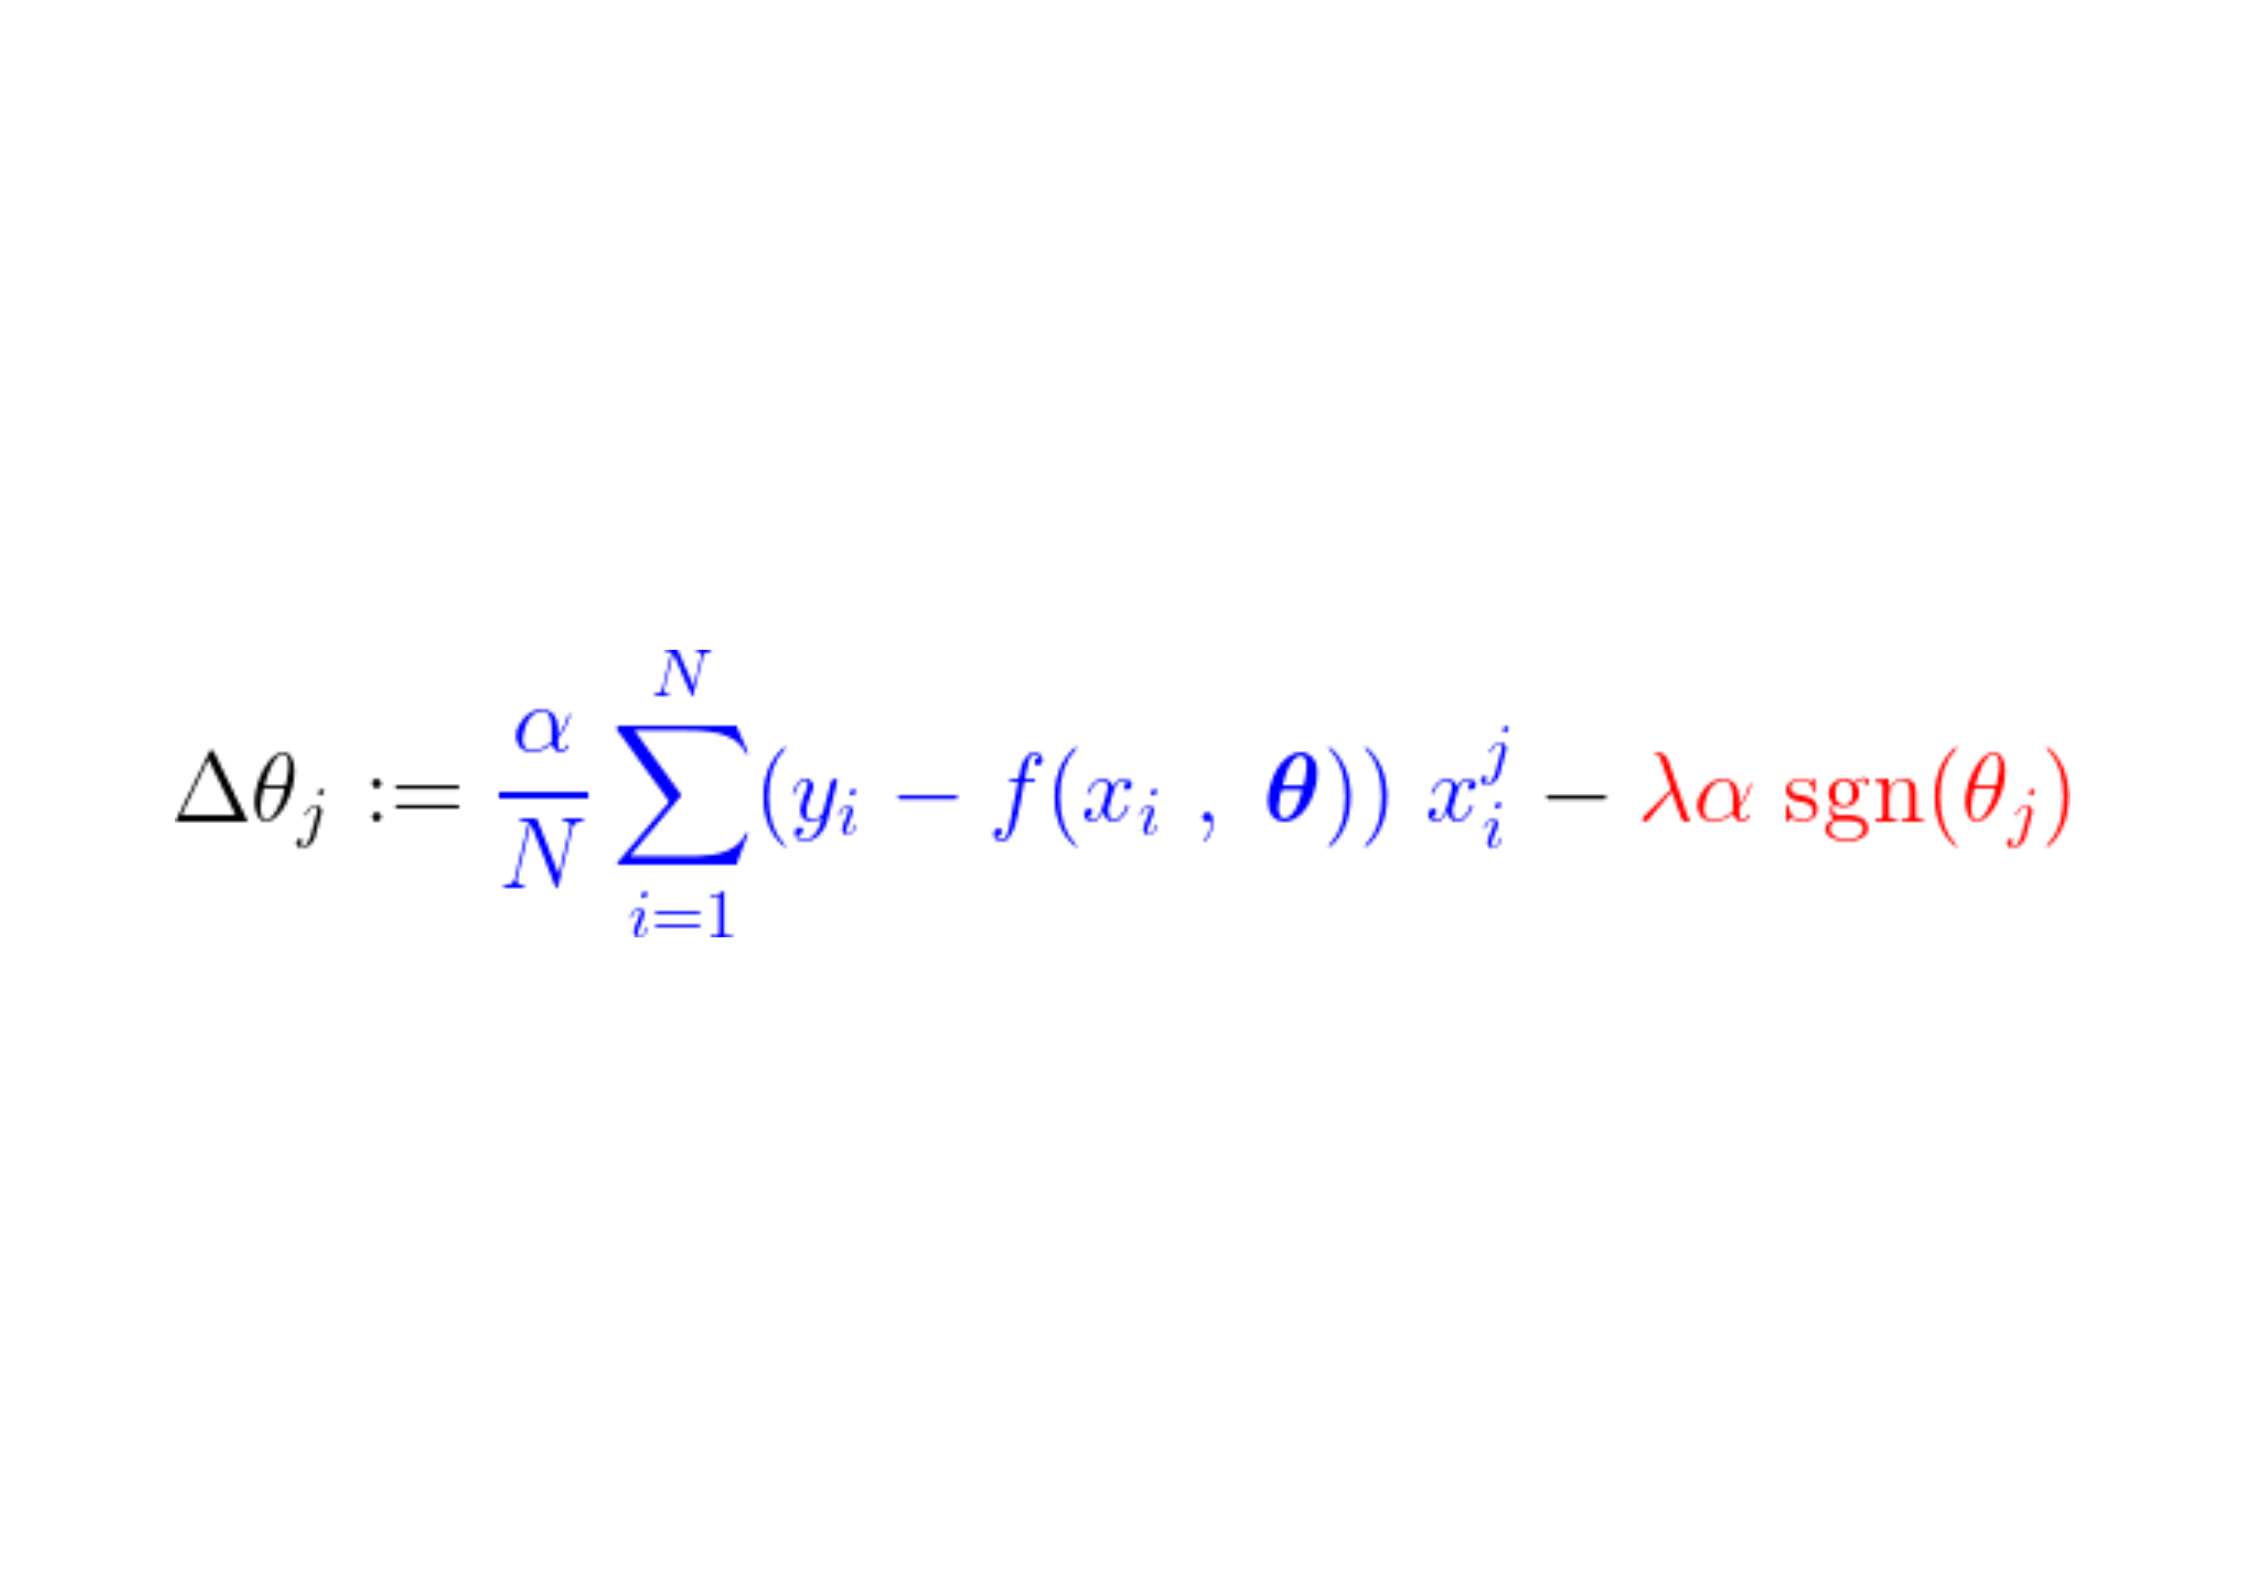
Metody wbudowane niejawnie identyfikują cechy bez użycia predefiniowanych kryteriów selekcji i wyodrębniają je z samych danych treningowych. Ten proces identyfikacji cech wewnętrznych jest częścią fazy treningu modelu. Model uczy się identyfikować cechy i jednocześnie formułować powiązane z nimi prognozy. W kolejnych sekcjach opiszemy rolę regularyzacji w tym procesie identyfikacji cech wewnętrznych, koncentrując się na regularyzacji L1 i jej roli w ulepszaniu modeli uczenia maszynowego.
Normalizacja i złożoność modelu: zaawansowane strategie poprawy wydajności
Regularyzacja to proces nakładania kar na złożoność modelu w celu uniknięcia nadmiernego dopasowania i uzyskania uogólnienia zadania.
W tym przypadku złożoność modelu jest analogiczna do jego zdolności adaptacji do wzorców w danych treningowych. Zakładając prosty model wielomianowy w ' x ' o stopniu ' d ', im wyższy stopień ' d ' wielomianu, tym bardziej elastyczny staje się model w wychwytywaniu wzorców w obserwowanych danych. Ta zwiększona elastyczność może prowadzić do zapamiętywania przez model danych treningowych zamiast uczenia się rzeczywistych wzorców, co zmniejsza jego zdolność do generalizacji na nowe dane.
Nadmierne dopasowanie i niedostateczne dopasowanie
Próba dopasowania modelu wielomianowego stopnia d = 2 do zbioru próbek treningowych uzyskanych z wielomianu trzeciego stopnia z pewnym szumem nie pozwoli na odpowiednie uchwycenie rozkładu próby. Modelowi brakuje po prostu elastyczności lub złożoności niezbędnej do modelowania danych generowanych przez wielomiany trzeciego stopnia (lub wyższego). Mówi się, że ten model jest niedopasowany do danych treningowych. Niedopasowanie wskazuje, że model jest zbyt uproszczony i nie jest w stanie uchwycić ukrytych wzorców w danych.
Pracując z tym samym przykładem, załóżmy teraz, że mamy model o stopniu d = 6. Teraz, przy zwiększonej złożoności, model powinien łatwo oszacować oryginalny wielomian sześcienny użyty do wygenerowania danych (np. ustawiając współczynniki wszystkich wyrazów z wykładnikami > 3 na 0). Jeśli proces uczenia nie zostanie zakończony na czas, model będzie nadal wykorzystywał swoją dodatkową elastyczność, aby jeszcze bardziej zmniejszyć błąd i zacznie również wychwytywać próbki szumu. To znacznie zmniejszy błąd uczenia, ale model będzie teraz cierpiał z powodu przeciążenia danych uczących. Szum zmieni się w ustawieniach rzeczywistych (lub podczas testowania), a wszelka wiedza oparta na przewidywaniach zostanie zakłócona, co spowoduje wysoki błąd testowania. Przeciążenie oznacza, że model jest zbyt złożony i uczy się szumu zamiast rzeczywistego sygnału.
Jak określić optymalną złożoność modelu?
W praktyce często mamy ograniczoną lub żadną wiedzę na temat procesu generowania danych lub rzeczywistego rozkładu danych. Znalezienie optymalnego modelu o odpowiedniej złożoności, który nie będzie nadmiernie lub niedostatecznie dopasowany, stanowi poważne wyzwanie. Wymaga to zastosowania skutecznych metod oceny wydajności modelu i określenia odpowiedniej złożoności, zapewniającej najlepszą równowagę między dokładnością a ogólnością. Stosując odpowiednie metryki i techniki ewaluacji, takie jak walidacja krzyżowa, praktycy mogą zidentyfikować model, który najlepiej sprawdza się na niewidocznych danych, unikając w ten sposób problemów z nadmiernym lub niedostatecznym dopasowaniem.
Jedną z możliwych technik jest rozpoczęcie od wystarczająco solidnego modelu, a następnie zmniejszenie jego złożoności poprzez dobór cech. Im mniej cech, tym mniej złożony jest model.
Jak omówiliśmy w poprzedniej sekcji, selekcja cech może być jawna (metody filtrowania, metody splotu) lub niejawna. Nadmiarowe cechy, które nie są krytyczne dla określenia wartości zmiennej docelowej, muszą zostać wyeliminowane, aby zapobiec uczeniu się przez model wzorców, które nie są ze sobą powiązane. Regularyzacja również realizuje podobne zadanie. Jaki jest zatem związek regularyzacji i selekcji cech z osiągnięciem wspólnego celu, jakim jest optymalna złożoność modelu? Zmniejszenie złożoności w modelach uczenia maszynowego ma kluczowe znaczenie dla poprawy wydajności i uniknięcia nadmiernego dopasowania, na czym koncentrują się zarówno regularyzacja, jak i selekcja cech.
Regularizacja L1 jako wyznacznik cech
Kontynuując nasz model wielomianowy, przedstawiamy go jako funkcję f, z danymi wejściowymi x , współczynnikami θ i stopniem d ,
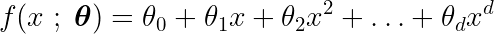
W przypadku modelu wielomianowego każdą potęgę zmiennej wejściowej x_i można traktować jako cechę, tworząc wektor w następujący sposób:
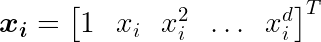
Definiujemy również funkcję celu, której redukcja prowadzi do idealnych parametrów θ* i obejmuje termin regularyzacji , który penalizuje złożoność modelu.
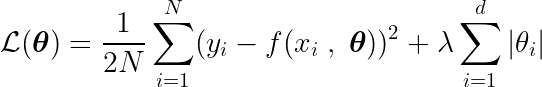
Aby znaleźć minimum tej funkcji, musimy przeanalizować wszystkie punkty krytyczne, czyli punkty, w których pochodna jest równa zero lub nieokreślona.
Pochodną cząstkową względem jednego z parametrów, θj , można zapisać następująco:
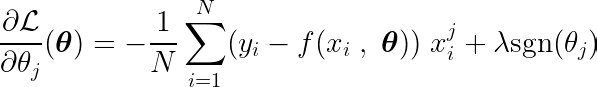
Funkcja sgn jest zdefiniowana następująco:
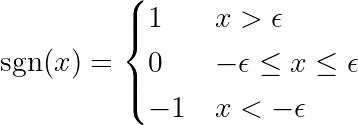
Uwaga : Pochodna funkcji bezwzględnej różni się od funkcji znaku (sgn) zdefiniowanej powyżej. Pierwotna pochodna jest niezdefiniowana dla x = 0. Rozszerzamy definicję, usuwając punkt przegięcia dla x = 0 i czyniąc funkcję różniczkowalną w całej dziedzinie. Co więcej, frameworki uczenia maszynowego (ML) używają tych rozszerzonych funkcji, gdy podstawowe operacje arytmetyczne obejmują funkcję bezwzględną. Sprawdź ten link na forum PyTorch.
Obliczając pochodną cząstkową funkcji celu względem jednego współczynnika θj i przypisując ją do zera, możemy skonstruować równanie wiążące optymalną wartość θj z przewidywaniami, celami i cechami.
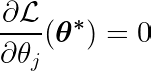
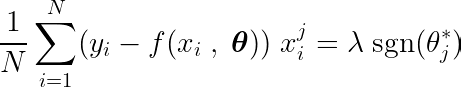
Przyjrzyjmy się powyższemu równaniu. Jeśli założymy, że dane wejściowe i docelowe były skoncentrowane wokół średniej (tj. że dane zostały znormalizowane na etapie wstępnego przetwarzania), wówczas lewa strona (LHS) efektywnie reprezentuje wariancję między numerem cechy j a różnicą między wartością oczekiwaną a wartością docelową.
Kowariancja statystyczna pomiędzy dwiema zmiennymi określa, w jakim stopniu jedna zmienna wpływa na wartość drugiej zmiennej (i odwrotnie).
Funkcja znaku po prawej stronie wymusza na wariancji po lewej stronie przyjęcie tylko trzech wartości (ponieważ funkcja znaku zwraca tylko -1, 0 i 1). Jeśli cecha j jest zbędna i nie wpływa na prognozy, wariancja będzie bliska zeru, co spowoduje, że odpowiadający jej współczynnik θj* będzie równy zero. Powoduje to usunięcie cechy z modelu. Ten proces pomaga zmniejszyć złożoność i poprawić wydajność modelu.
Wyobraź sobie funkcję sygnału jako kanion wyrzeźbiony przez wodę. Możesz przejść przez kanion (czyli koryto rzeki), ale aby się wydostać, napotkasz ogromne bariery lub strome zbocza. Regularyzacja L1 tworzy efekt „progowy” podobny do gradientu funkcji straty. Gradient musi być wystarczająco silny, aby przebić się przez bariery lub osiągnąć zero, co ostatecznie spowoduje, że wartość parametru wyniesie zero.
Aby podać bardziej realistyczny przykład, rozważmy zbiór danych zawierający próbki pochodzące z linii prostej (model dwuparametrowy) z pewnym dodanym szumem. Optymalny model powinien mieć nie więcej niż dwa parametry; w przeciwnym razie dostosuje się do szumu w danych (z dodatkową swobodą/potęgą wielomianu). Zmiana parametrów o wyższej mocy w modelu wielomianowym nie wpływa na różnicę między wartościami docelowymi a przewidywaniami modelu, zmniejszając tym samym jego wariancję z cechą.
W trakcie procesu uczenia, stały krok jest dodawany/odejmowany od gradientu funkcji straty. Jeśli gradient funkcji straty (MSE – średni błąd kwadratowy) jest mniejszy niż stały krok, współczynnik ostatecznie osiągnie 0. Zwróć uwagę na poniższe równanie, które obrazuje, jak współczynniki są aktualizowane za pomocą metody gradientu prostego:

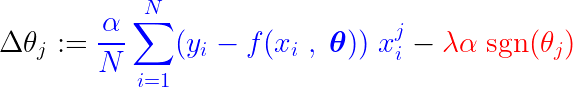
Jeśli niebieska część powyżej jest mniejsza niż λα , która sama w sobie jest bardzo małą liczbą, wówczas Δθj jest w przybliżeniu stałym krokiem λα . Znak tego kroku (czerwonej części) zależy od sgn(θj) , którego wynik zależy od θj . Jeśli wartość θj jest dodatnia, tj. większa niż ε , wówczas sgn(θj) jest równe 1, co sprawia, że Δθj jest w przybliżeniu równe -λα , przesuwając je w kierunku zera.
Aby stłumić stały krok (część czerwona), który powoduje zerowanie parametru, gradient funkcji straty (część niebieska) musi być większy niż rozmiar kroku. Aby uzyskać większy gradient funkcji straty, wartość cechy musi znacząco wpływać na wynik modelu.
W ten sposób cecha, a dokładniej jej odpowiedni parametr, którego wartość nie jest związana z wynikami modelu, zostaje zerowana przez regularyzację L1 w trakcie treningu.
Dalsze czytanie i wnioski
- Aby uzyskać więcej informacji na ten temat, zamieściłem pytanie na Reddicie r/MachineLearning iPodejmować właściwe kroki Zawiera różne interpretacje, które możesz chcieć przeczytać.
- Madiyar Aitbayev ma również Ciekawy blog Odpowiada na to samo pytanie, ale podaje wyjaśnienie geometryczne.
- Blog Brian King wyjaśnia koncepcję organizacji z perspektywy probabilistycznej.
- To Dyskusja Na stronie CrossValidated wyjaśnia, dlaczego norma L1 zachęca do stosowania modeli rzadkich. Blog Szczegółowy artykuł Mukula Ranjana wyjaśnia, dlaczego norma L1 zachęca do tego, aby transakcje osiągnęły zero, a norma L2 nie.
„Regulacja L1 wybiera cechy” to proste stwierdzenie, z którym zgadza się większość osób uczących się uczenia maszynowego, bez zagłębiania się w jego wewnętrzne mechanizmy. Niniejszy blog jest próbą podzielenia się z czytelnikami moją wiedzą i modelem mentalnym, aby intuicyjnie odpowiedzieć na to pytanie. W przypadku sugestii i pytań mój adres e-mail znajduje się na mojej stronie internetowej . Ucz się dalej i miłego dnia!
Możliwość dodawania komentarzy nie jest dostępna.